
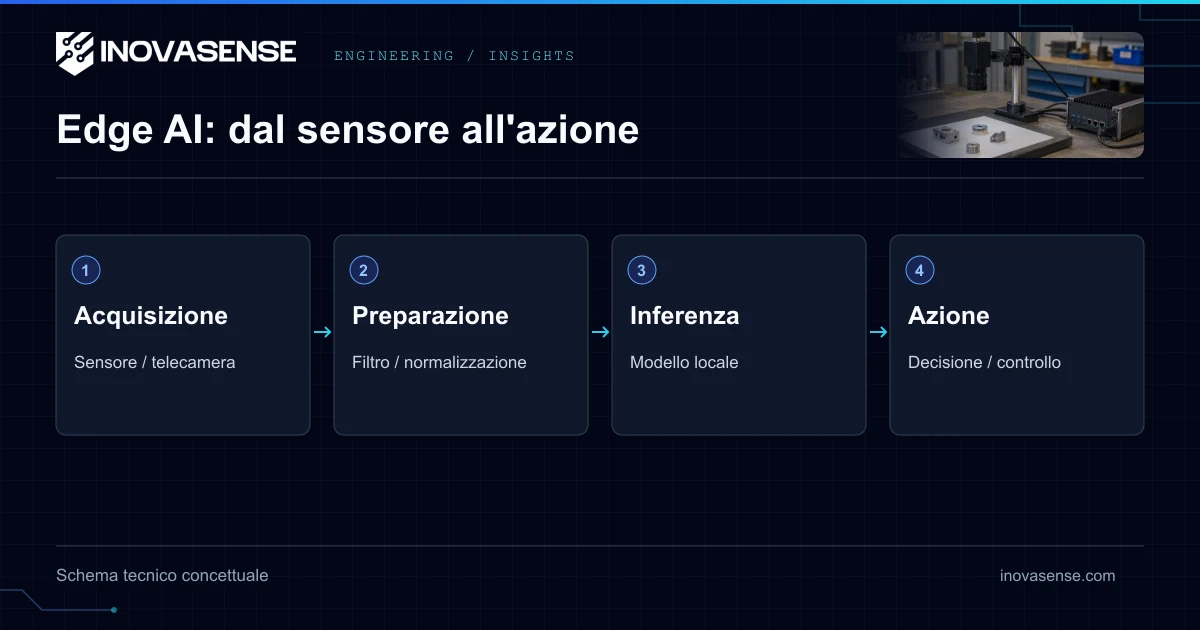
L’Edge AI esegue l’inferenza vicino al sensore o all’utente. Può ridurre i trasferimenti e la dipendenza da una risposta cloud. Non garantisce una latenza, autonomia, riservatezza o accuratezza specifica: dipendono dal modello, dall’hardware e dall’applicazione completa.
Partire da criteri di accettazione
Per il monitoraggio delle vibrazioni definite guasti, regimi operativi e costo delle mancate rilevazioni. Per l’ispezione visiva definite difetti, illuminazione, velocità della linea e falsi scarti accettabili. Per usi medici o di sicurezza definite destinazione d’uso e requisiti di validazione prima di scegliere il modello.
Separate dati di addestramento, validazione e test per macchina, sessione o periodo rilevante. Riportate precision/recall, falsi allarmi e prestazioni in nuove condizioni. Un risultato su un dataset non dimostra un’accuratezza universale del 96% né un preavviso di manutenzione garantito di settimane.
Prestazioni hardware: unità e condizioni
| Piattaforma | Capacità pubblicata | Interpretazione |
|---|---|---|
| ESP32-P4 | Core CPU ad alte prestazioni fino a 400 MHz | MHz indica frequenza, non una prestazione AI di 400 GOPS |
| STM32N6 | NPU Neural-ART fino a 600 GOPS | Picco dichiarato dell’acceleratore; operatori supportati e memoria influenzano il risultato |
| Jetson Orin Nano | Fino a 67 TOPS, modalità del modulo configurabili tra 7 e 25 W | Picco sparse INT8 nella configurazione appropriata; non potenza dell’intero sistema né latenza del modello |
| NXP i.MX 8M Plus | NPU fino a 2,3 TOPS | Picco NPU del fornitore; misurare modello e scheda completi |
La documentazione dei fornitori collegata definisce le condizioni. Per confrontare TOPS/GOPS devono coincidere precisione, ipotesi di sparsità e convenzioni di conteggio. Un acceleratore con picco maggiore può essere più lento per un operatore non supportato o una pipeline limitata da acquisizione e preprocessing CPU.
TinyML su MCU è adatto a modelli sufficientemente piccoli e compiti sensoriali circoscritti. Processori applicativi e NPU possono gestire modelli di visione più grandi. Pipeline FPGA consentono elaborazione parallela configurabile ma richiedono mapping, timing e progetto della memoria. Scegliete rispetto a requisiti misurati.
Misurare tutta la pipeline
Misurate acquisizione, preprocessing, inferenza e gestione dell’uscita separatamente, poi la latenza totale, inclusi p95/p99 quando contano le scadenze. Indicate versione del modello, dimensioni dell’input, batch, precisione, clock e temperatura. Misurate energia per inferenza e a riposo sulla scheda completa con sensori e comunicazioni.
La quantizzazione può ridurre dimensioni e calcolo, ma la variazione di accuratezza dipende da dati di calibrazione e compito. Non esiste una perdita universale inferiore al 2%. Un modello linguistico richiede RAM anche per buffer e KV cache, oltre ai pesi; “piccolo modello” non significa automaticamente compatibile con un MCU.
Riservatezza, sicurezza e manutenzione
L’elaborazione locale può minimizzare i trasferimenti, ma i dati personali restano soggetti al GDPR. Log, telemetria, immagini conservate e assistenza remota possono ancora divulgarli. Decidete cosa conservare, trasmettere ed eliminare.
Un rilevatore di anomalie non è automaticamente una funzione di arresto d’emergenza validata. Per usi di sicurezza definite architettura, protezioni indipendenti ed evidenze per l’impiego previsto. Autenticate gli aggiornamenti di modello e firmware, conservate test versionati e monitorate il cambiamento della distribuzione dei dati dopo il rilascio.
Ambito dell’AI Act
La classificazione dipende dall’uso previsto e dal ruolo dell’operatore, non dalla sede dell’inferenza. Un modello locale non è automaticamente conforme né ad alto rischio. Secondo il calendario attuale della Commissione, l’applicazione generale decorre dal 2 agosto 2026; le regole ad alto rischio dell’allegato III dal 2 dicembre 2027 e quelle dei prodotti regolamentati ad alto rischio dal 2 agosto 2028. Applicate categoria e disposizioni transitorie pertinenti.
Servizi Edge AI · Scelta MCU · Legislazione hardware UE · Parliamo della validazione
Domande frequenti
L’Edge AI garantisce inferenza sotto 10 ms?
No. La latenza dipende da modello, hardware, memoria, acquisizione e preprocessing. Misurate la latenza completa sul prodotto reale e indicate le condizioni.
ESP32-P4 offre 400 GOPS?
La specifica Espressif citata indica un clock CPU fino a 400 MHz. Non è una specifica pubblicata di prestazione NPU da 400 GOPS.
Posso confrontare direttamente i TOPS di tutti i fornitori?
Solo verificando precisione, sparsità, conteggio delle operazioni e configurazione. Il throughput di picco non misura latenza del modello o energia dell’intero sistema.
L’inferenza locale è automaticamente conforme a GDPR e AI Act?
No. Il GDPR dipende dal trattamento di dati personali; l’AI Act dall’uso previsto, dalla classificazione e dal ruolo. L’esecuzione locale da sola non dimostra nessuna delle due conformità.
Fonti primarie
Riferimenti tecnici e normativi verificati il 1° ottobre 2026.